量子计算的应用在哪里?
个人观点,不构成投资建议
量子计算需要寻找应用。
这句话在 2026 年显得尤为荒诞:学术界和工业界投入了大量资源,但我们仍然不知道量子计算究竟在哪些有实用价值的问题上能超过经典计算。
这个问题比十年前更为急迫,硬件已经跨过纠错阈值,逻辑比特数每年翻倍;与此同时,宣称的“量子优势”平均只能存活半年,就会被经典模拟再次打破。
本文尝试用一套统一的标准,即经典难、量子易、有人愿意付费,对过去十年人们所探索的方向进行系统梳理。
结论如下:其一,通用计算任务(数据排序、傅里叶变换、存储、拟合、偏微分方程、通用优化、蒙特卡洛等)基本没戏,它们要么在信息论上就不可能有加速,要么最多只有二次加速,在纠错开销下完全不划算;其二,所有试图用一百个物理比特加经典后处理来展示量子优势的路线,例如 IBM 的采样对角化(SQD)和嵌入分治,其本质都是经典后处理承担了全部实际工作。
即使从精确基态采样,SQD 也不比经典 SCI 好,而强关联恰恰破坏了这一方法所依赖的稀疏前提;量超融合之所以能把万原子体系切成一百比特以内的碎片,正是靠局域关联这一假设,而这一假设又使得经典局域方法能够高效解决问题。
因此,真正的应用只剩一条路:精确求解一百到两百轨道以上、高纠缠、且值钱的量子系统。
使用 Claude Fable 5.1 广泛调研后发现,在化学材料领域,企业对精度有要求、经典确实做不到的问题只有 OLED 发光体,但需要上千逻辑比特的容错量子计算机。
因此,未来五年的目标或许需要从寻找实用量子优势转变为祈祷 AI 能帮上忙。
1. 为什么 2026 年还在问这个问题
2019 年 Google 宣布“量子霸权”的时候,很多人以为量子计算马上就要在各个领域大放异彩。
七年过去,硬件确实进步了,Willow 上实现了低于阈值的表面码 [1],Quantinuum Helios 有 48 个纠错逻辑比特,IBM 的路线图里将 200 逻辑比特、一亿门的 Starling 排在 2029 年。
但是,寻找有实际应用价值的量子优势并没有什么进展,每个潜在方案都很快被经典方法打破:
尚没有被经典算法成功模拟的只有三个实验:Google Willow 的随机电路采样、OTOC 实验,以及 Quantinuum 的 Floquet 预热化。
然而,这三个问题的共同点是没有实际应用场景。
Google 自己在 2025 年承认,“找到具体有量子优势的案例,并与真实应用场景联系,是必要但严重欠缺的工作” [12];有人把这条路称为 “the fraught road to quantum advantage” [13]。
最近半年,我和不少投资人、产业界的人聊过。
我发现大家对应用这个词的理解很不一样。
我说量子计算的应用是组合优化、素因数分解,对方一脸茫然。
然后我发现他们理解的应用是气象预报、材料性质预测、金融定价、电池电解液设计。
因为我们所谈论的应用其实在两个层次上。
气象预报是一个应用,它背后的计算问题是求解偏微分方程;电解液设计是一个应用,它背后的计算问题是分子的基态能量和反应路径;金融定价是应用,背后是蒙特卡洛积分和随机微分方程。
量子领域的学者几乎只谈第二层计算问题,产业和资本只关心第一层应用场景。
某个应用场景里的瓶颈,是否恰好是能被量子算法加速,我们目前并没有答案。
如果量子计算只能用来模拟量子多体系统的时间演化,它绝对不值得这么多投入。
我们希望能解决一个 long-standing 的工业问题,或者是一个在很多场景里都会用到的基础计算任务(如傅里叶变换)。
在量子计算资源方面,要么能在五年内用一百个逻辑比特演示,要么像 Shor 算法一样有复杂度证明,或者至少有数值标度证据表明它将来应该有用。
2. 三个关键维度
大多数讨论量子应用的论文只回答一个问题:量子算法是不是比经典算法快。
而基本所有创业公司的融资 PPT 里只讨论另一个问题:应用领域的市场规模有多大。
这两件事情都很重要,但放在一起讨论的话,结果却十分悲观。
首先是经典难。
难度可以从多种层次进行讨论,严谨的是复杂度分析,但大家更常用的论据是“实践表明经典算法很慢”,这点常常可以通过换个经典算法或者是对经典算法进行优化来解决(上面提到的所有攻破量子优势基本都是这条路)。
其次是量子易。
我们要求量子算法能在多项式时间内跑完,这一要求其实并不低,但几乎总被人们忽略。
很多专业学者甚至都以为量子计算可以轻松求解哈密顿量基态问题(并且因此能求解各种组合优化问题),然而这是完完全全的误区:局域哈密顿量的基态问题是标准的 QMA-complete,无能隙/高度阻挫的局域系统难以用量子计算解决(因为绝热演化不收敛),更何况大部分组合优化问题的图是完全稠密的,压根没法用只有局域相互作用的量子系统进行模拟。
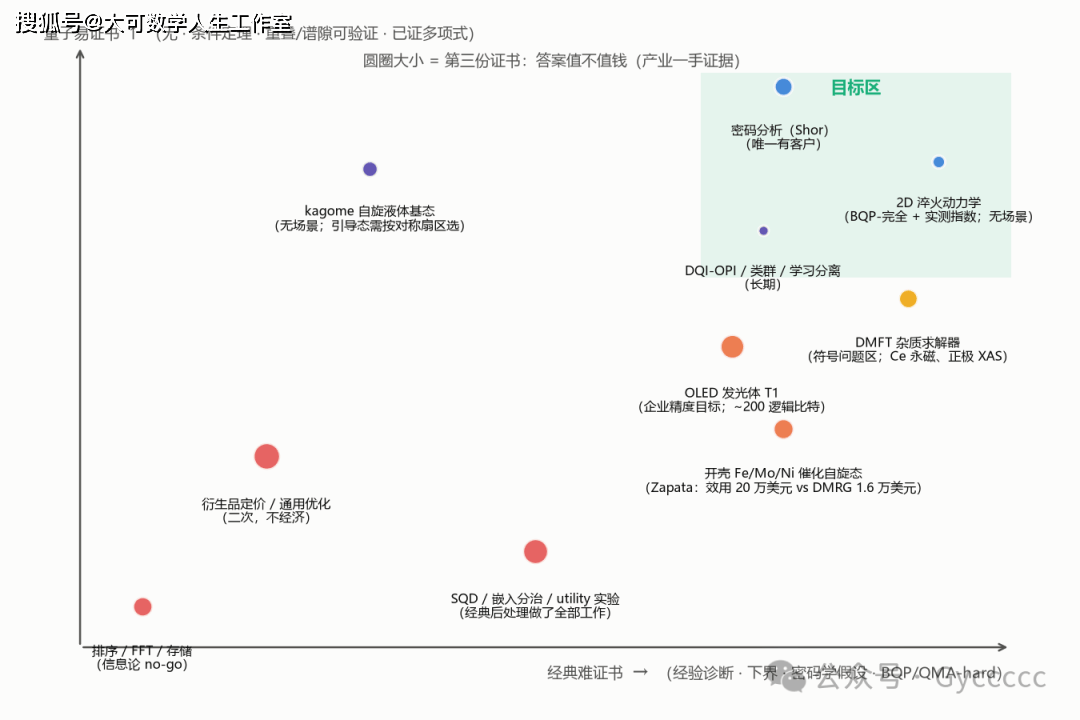
最后是有人愿意付费。
算得更准,不等于有商业价值。
我之前和一些做电解液的同学聊过,他们认为 DFT 的精度就够用,更重要的是希望能大幅加速以实现高通量筛选,这也是为什么现在机器学习势函数对他们来说是一个很棒的解决方案。
所以我们要寻找的是更高精度能换来更大价值的领域,而这需要产业侧的一手证据,不能只靠臆想。
假设我们出一张考卷,经典计算可以在 1 小时内考到 90 分,但是如果要考到 100 分,则需要花 10000 个小时;量子计算可能可以在 1 小时内就考到 100 分。
所以达到同样的分数(100 分),量子计算更快;而在同样的时间预算下(1 小时),量子计算更准。
但很多场景下边际效益递减,只需要考 90 分就足够,那量子计算就完全没有用武之地。
所以,我们需要寻找的是最后 10 分的进步能换来足够价值的领域。
3. 通用计算任务:根本没用
先看最广泛、也最常被误解的一类,即和量子物理无关的通用算法。
有一批任务在信息论上就不可能有加速。
排序在比较模型下量子也需要 Ω(N log N) 次比较,而且输出 N 个元素本身就要 Ω(N)。
傅里叶变换更有意思:QFT 的指数加速作用在振幅上,编码 N 个经典数据要 Ω(N),读出全部系数也要 Ω(N),QFT 电路的经典模拟就是 FFT。
经典数据存储受 Holevo 界限制,使用 n 个量子比特能够存储的经典比特不超过 n;QRAM 只是寻址结构,同样的控制硬件拿来跑并行经典算法一样快。
无结构搜索和通用优化最多二次加速,Grover 算法已经是最优。
但是,二次加速完全不划算 [14]:逻辑门需要 10 - 100 μs,而经典的一步操作约 0.3 ns,相差五个数量级。
二次加速要打破盈亏点,在对经典最不利的案例里也至少需要 5×10⁵ 次迭代,对应 2.4 小时的运行;这还是不允许经典并行的情况,若经典侧允许并行,盈亏点达到 100 天以上(也就是说,得在经典 100 天都跑不完的任务上,量子才可能有优势)。
超越多项式的加速只剩四类:代数数论(素因数分解、离散对数、隐子群),有代数结构的解码和优化(DQI),稀疏、输入紧凑、输出为单个泛函的矩阵运算,以及量子系统本身的模拟。
前三类我让 Claude 逐一调研了对应的工业问题:
经典数据的量子机器学习也难以实用化,低秩情形、核方法与变分模型都难以超越经典算法,唯一可以证明的优势建立在人工构造的数据集上。
所以在通用计算任务这条线上,找不到既有工业场景又有超二次加速的问题。
剩下的应用只能来自费曼的想象,也就是用量子计算机去模拟另一个量子系统。
4. 一百个物理比特:量子能做,但经典易
如果应用只能来自量子系统的模拟,而一台容错的量子计算机还要好几年才能出现,那我们只能采用量超融合的想法(没错,就是现在基本每家公司都在讲的故事),先用今天的一百个物理比特做量子部分,其余交给经典超算。
过去三年有三条这样的路线。
第一条路线是动力学实验 + 错误缓解。
IBM 2023 年在 127 比特的六边形格点上跑 kicked-Ising 动力学,用零噪声外推得到局域可观测量。
几周之内,就被经典算法用一台笔记本打破 [3] [4]。
这个结果是必然的:局域噪声使得任意可观测量都可以在多项式时间内被经典模拟 [18]。
第二条路线是采样对角化计算基态能量,也就是 IBM “量子中心超算”的核心方法:使用量子计算机进行采样,再在采到的子空间里用经典计算进行对角化。
它在 77 比特上做了氮分子和铁硫簇 [10],2026 年扩展到万原子蛋白。
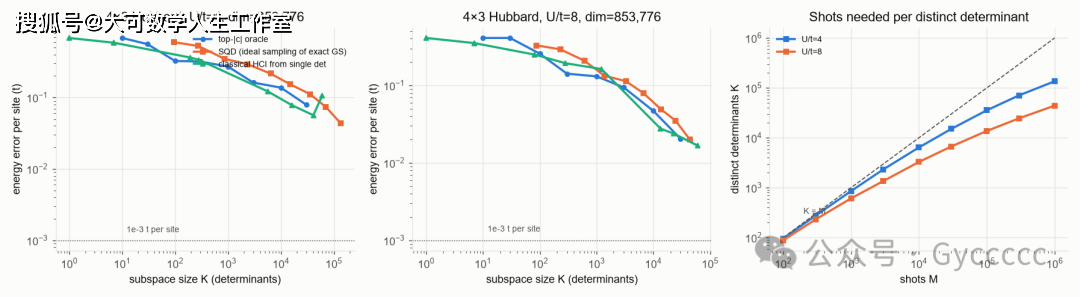
我做了一个小规模测试(我调研了一下,居然几乎没有人做过这个对比,感兴趣的同学可以拿去扩展,我感觉至少能水一篇 PRB)回答一个顶层设计的问题:假如上帝给了我们一个完美的精确基态,从它采样得到的子空间,会比经典选择更好吗?我测试了半填充 Hubbard 模型(4×3),结果如下图所示。
量子采样并不比经典选择更好,更重要的是,U/t = 4 时(也就是经典最难算的强关联区域),基态的分布是弥散的,即使子空间达到全空间的 16%,能量误差仍有 0.04 t/site,离化学精度 10⁻³ 差 40 倍。
采样方法成立的前提是基态稀疏,这一点对弱关联成立,对强关联不成立,而后者正是量子计算被寄予厚望的地方。
更讽刺的是,从均匀随机的比特串出发,经两轮经典 configuration recovery 就能达到同样的精度。
因此在 IBM 的实验里,起作用的是经典后处理,并非量子采样器。
第三条是嵌入分治,把大分子切成一百比特以内的切片。
2026 年 5 月,克利夫兰诊所、RIKEN 和 IBM 用波函数嵌入处理了 12,635 原子的胰蛋白酶配体复合物 [19]。
从原理来说,所有嵌入方法(DMET、EWF、bootstrap、投影嵌入)都依赖关联的局域性:有能隙体系的关联函数随 exp(−r/ξ) 衰减。
在绝缘体和闭壳层分子里,切片可以很小,但经典的局域方法同样够用;在金属、临界点和掺杂的 Mott 材料里关联长度发散,而切片必须大于关联长度才能达到所需精度。
比如,二维 Hubbard 模型的条纹/配对序计算往往需要 8×8 以上的格点簇,加上 bath 就是 256 比特以上。
两个方向都没有给现在的量子计算机留下空间。
5. 基态计算:精度不等于钱
即使我们在某个分子计算的问题里找到了量子优势,又能如何呢?算对了,有人愿意付钱吗?
一项由 46 位作者完成的固氮催化剂评估文章提供了商业化价值的参考 [22]:案例最高标价 20 万美元,对应的 DMRG 成本约 40 万 CPU 核时,按论文每核时 0.04 美元(当然,国内算力便宜得多)计约 1.6 万美元;量子端则需要 8,478 逻辑比特、1.4×10¹² 个 Toffoli,远远不是 10 年内的量子计算机能够做到的。
6. 动力学计算:有用和能做难以兼得
相比之下,量子多体动力学有一个别的领域都没有的优点:它用经典计算机真的算不动。
二维横场 Ising 在 11×11 的规模下、MPS、TTN、BP-TN、NQS 全部失效 [23];而此时量子电路只需约 140 个逻辑比特和 4×10⁴ 个 Toffoli 门,对逻辑错误率的要求大概在 10⁻⁵ 左右,乐观估计 2029 年就能实现 [12]。
然而问题出在第三个维度:这个规模的量子多体动力学仅仅是凝聚态与统计物理领域感兴趣的东西,实在是找不到企业为它付钱。
如果我们有更大规模的系统,或许能找到一些应用。
动力学平均场理论(DMFT)[24] 可以用于计算不少工业界上感兴趣的谱学信息,比如 3d 氧化物的核能级谱、电池正极的 operando XAS、XPS 和 RIXS。
人们关心稀土永磁能否用便宜的 Ce 替代 Nd,而日本 ESICMM(与丰田联动)目前用 Hubbard-I 的原子极限刻意绕开真正的 f 壳动态求解。
核燃料与核废料的 UO₂、PuO₂ 5f 谱,则已经有国家实验室级别的潜在客户(介于科研和工业之间)。
要把 50 到 100 比特的杂质模型演化足够的时间以达到 10 meV 的分辨率,所需的 T 门总数在 10⁸ 到 10¹⁰ 之间,远远不是 10 年内能够实现的规模。
6. 新大陆在哪里
我不知道。
找既有优势又有实用价值的量子算法对我们这代人类来说几乎是不可能完成的任务,整个领域过去 40 年来的发展证明了这一点,希望只能寄托在下一代上。
当然,是下一代 LLM。
[1] Google Quantum AI, Quantum error correction below the surface code threshold, Nature 638, 920 (2024).
[2] Y. Kim et al. (IBM), Evidence for the utility of quantum computing before fault tolerance, Nature 618, 500 (2023).
[3] J. Tindall, M. Fishman, E. M. Stoudenmire, D. Sels, Efficient tensor network simulation of IBMs Eagle kicked Ising experiment, PRX Quantum 5, 010308 (2024).
[4] T. Begušić, J. Gray, G. K.-L. Chan, Fast and converged classical simulations of evidence for the utility of quantum computing before fault tolerance, Sci. Adv. 10, eadk4321 (2024).
[5] A. D. King et al. (D-Wave), Beyond-classical computation in quantum simulation, Science 388, 199 (2025).
[6] J. Tindall, A. Mello, M. Fishman, E. M. Stoudenmire, D. Sels, Dynamics of disordered quantum systems with two- and three-dimensional tensor networks, Science 392, 868 (2026).
[7] G. S. Hartnett et al. (Q-CTRL), Fast, accurate, high-resolution simulation of large-scale Fermi–Hubbard models on a digital quantum processor, arXiv:2605.04025 (2026).
[8] R. Rausch, S. Singh, S. S. Jahromi, A. Kshetrimayum, R. Orús, Pushing the classical frontier of 1D Fermi–Hubbard quench dynamics beyond current quantum simulations, arXiv:2606.04771 (2026).
[9] D. Kremer, F. Dupuis, Efficient classical simulation of heuristic peaked quantum circuits, arXiv:2604.21908 (2026).
[10] J. Robledo-Moreno et al., Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer, Sci. Adv. 11, eadu9991 (2025).
[11] K. Belagali et al., Efficient classical simulation of large-scale unitary cluster Jastrow circuits, arXiv:2607.21337 (2026).
[12] R. Babbush et al. (Google Quantum AI), The grand challenge of quantum applications, arXiv:2511.09124 (2025).
[13] J. Eisert, J. Preskill, Mind the gaps: the fraught road to quantum advantage, arXiv:2510.19928 (2025).
[14] R. Babbush, J. R. McClean, M. Newman, C. Gidney, S. Boixo, H. Neven, Focus beyond quadratic speedups for error-corrected quantum advantage, PRX Quantum 2, 010103 (2021).
[15] A. Scherer et al., Concrete resource analysis of the quantum linear-system algorithm used to compute the electromagnetic scattering cross section of a 2D target, Quantum Inf. Process. 16, 60 (2017).
[16] S. Chakrabarti et al., A threshold for quantum advantage in derivative pricing, Quantum 5, 463 (2021).
[17] C. Gidney, How to factor 2048 bit RSA integers with less than a million noisy qubits, arXiv:2505.15917 (2025).
[18] T. Schuster, C. Yin, X. Gao, N. Y. Yao, A polynomial-time classical algorithm for noisy quantum circuits, Phys. Rev. X 15, 041018 (2025).
[19] K. M. Merz Jr. et al., Crossing the 12,000-atom barrier with heterogeneous quantum-classical supercomputing: quantum chemistry of protein–ligand complexes, arXiv:2605.01138 (2026).
[20] Ö. Legeza et al., Hunting for quantum advantage in electronic structure calculations is a highly non-trivial task, arXiv:2603.28648 (2026).
[21] I. Genin et al. (OTI Lumionics / Samsung SAIT), Towards quantum advantage in chemistry, arXiv:2512.13657 (2025).
[22] N. Bellonzi et al. (Zapata), Feasibility of accelerating homogeneous catalyst discovery with fault-tolerant quantum computers, arXiv:2406.06335 (2024).
[23] J. Vovrosh et al., Simulating dynamics of the two-dimensional transverse-field Ising model: a comparative study of large-scale classical numerics, Phys. Rev. Research 8, 023311 (2026).
[24] B. Bauer, D. Wecker, A. J. Millis, M. B. Hastings, M. Troyer, Hybrid quantum-classical approach to correlated materials, Phys. Rev. X 6, 031045 (2016).
告别物理滑轨!派世推出双传感器鼠标:传感器想放哪放哪>>点击查看更多
时间晶体如何重塑我们的未来?>>点击查看更多
什么是“量子隧穿”?>>点击查看更多
美得有名堂EP.26|揭秘胶原织网抗衰原理>>点击查看更多
热门推荐