蛋白质序列生成:AI 如何像“写代码”一样“写”出蛋白质?
蛋白质是由约 20 种氨基酸按特定顺序连接而成的长链。
这条顺序——也就是序列——决定了蛋白质会折叠成什么样的三维结构,又具备什么功能。
天然蛋白种类虽多,却常满足不了工业和医药的特定需求:有的不够耐热,有的催化效率偏低,有的无法精准结合目标分子。
过去,科学家主要靠定向进化:对序列做随机突变,再制备大量变体去筛选。
然而一轮实验往往要测试成千上万个候选,周期长、成本高,“碰运气”的成分很大。
蛋白质序列生成的出现,改变的是这个搜索方式——它让模型先在数据里学会“什么顺序更合理、更可能具备目标功能”,再据此给出有方向的候选序列,把巨大的搜索空间大幅压缩。
打个比方:随机突变像“在黑暗里摸索”,而序列生成像“先看地图、再出发”。
它不保证一次成功,却能让你离答案更近。
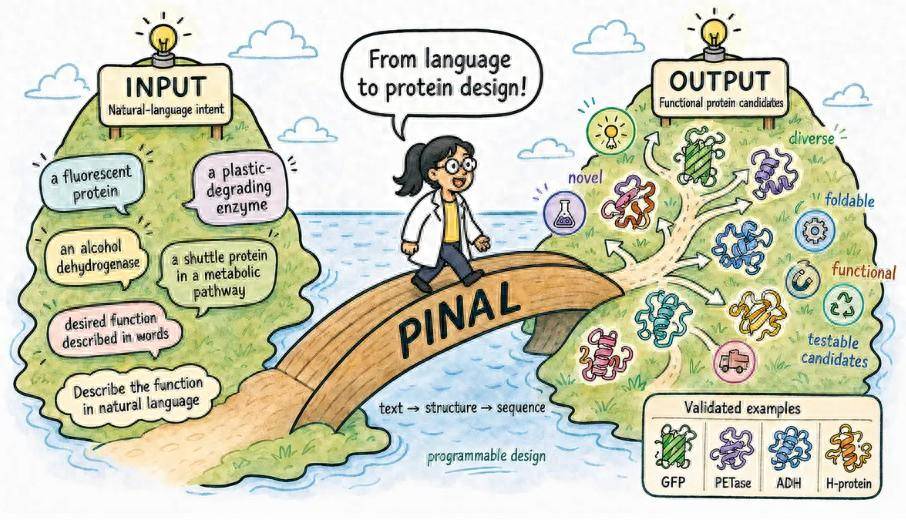
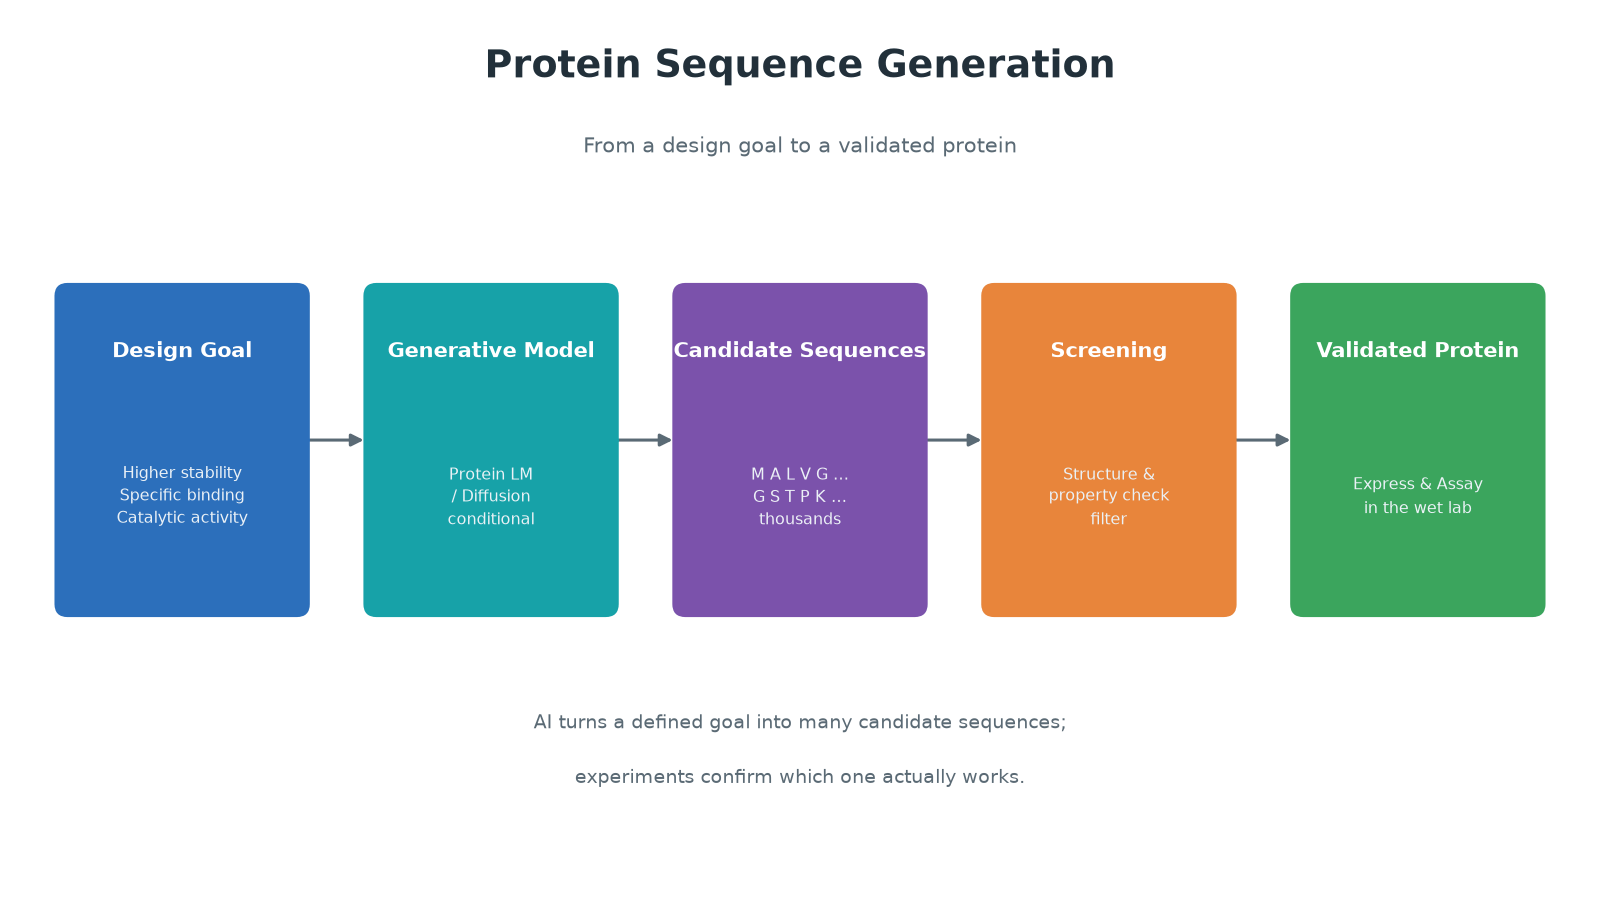 图1:从设计目标生成候选序列,实验验证可用蛋白
为什么我们需要“生成”蛋白质?
蛋白质序列生成把“先突变、后筛选”的偶然工程,转变成“先设计、再验证”的定向过程,让蛋白开发更高效、也更可控。
· 天然库有限:许多需求在自然界没有现成答案,需要人工“造”出新序列。
· 定向进化成本高:一轮随机突变加筛选,动辄上千上万个变体,时间和经费都吃紧。
· 生成模型给方向:从数据中学“序列—功能”规律,先给出有依据的候选,再聚焦验证。
· 类比:定向进化像“盲人摸象”,序列生成像“先看地图再出发”。
蛋白质序列生成的核心原理是什么?
蛋白质序列生成通常基于蛋白质语言模型或扩散模型,学习氨基酸序列的统计规律,并按目标性质进行条件化采样,生成新的候选序列。
氨基酸序列在结构上很像“语言”:20 种氨基酸如同 26 个字母,功能模体和结构域如同单词,折叠与互作规律如同语法。
正是这种相似性催生了蛋白质语言模型——它在海量天然序列上预训练,学会“什么样的顺序更常出现、更可能折叠成稳定结构”。
常见的生成方式有三种:
· 自回归生成(像逐字续写):模型每步预测下一个最可能的氨基酸,一个接一个“写”出整条序列。
· 掩码生成(像完形填空):遮住若干位置,再预测被遮挡的残基。
· 扩散模型(像从噪声显影):从一团“噪声”开始,逐步去噪、收敛成一条合理的序列。
更关键的是条件生成:把目标性质(更高热稳定、更强催化活性、更优结合亲和力)作为约束,让模型只生成“满足条件”的候选。
背后是一个核心概念——适应度景观(fitness landscape),它描述“序列改变”与“功能变化”之间的关系。
模型所做的,本质是在这张地图上“爬山”,朝更高适应度的区域移动。
但要强调:生成不等于保证。
模型给出的是“看起来合理”的候选,是否真的可折叠、可表达、有功能,还要靠后续验证。
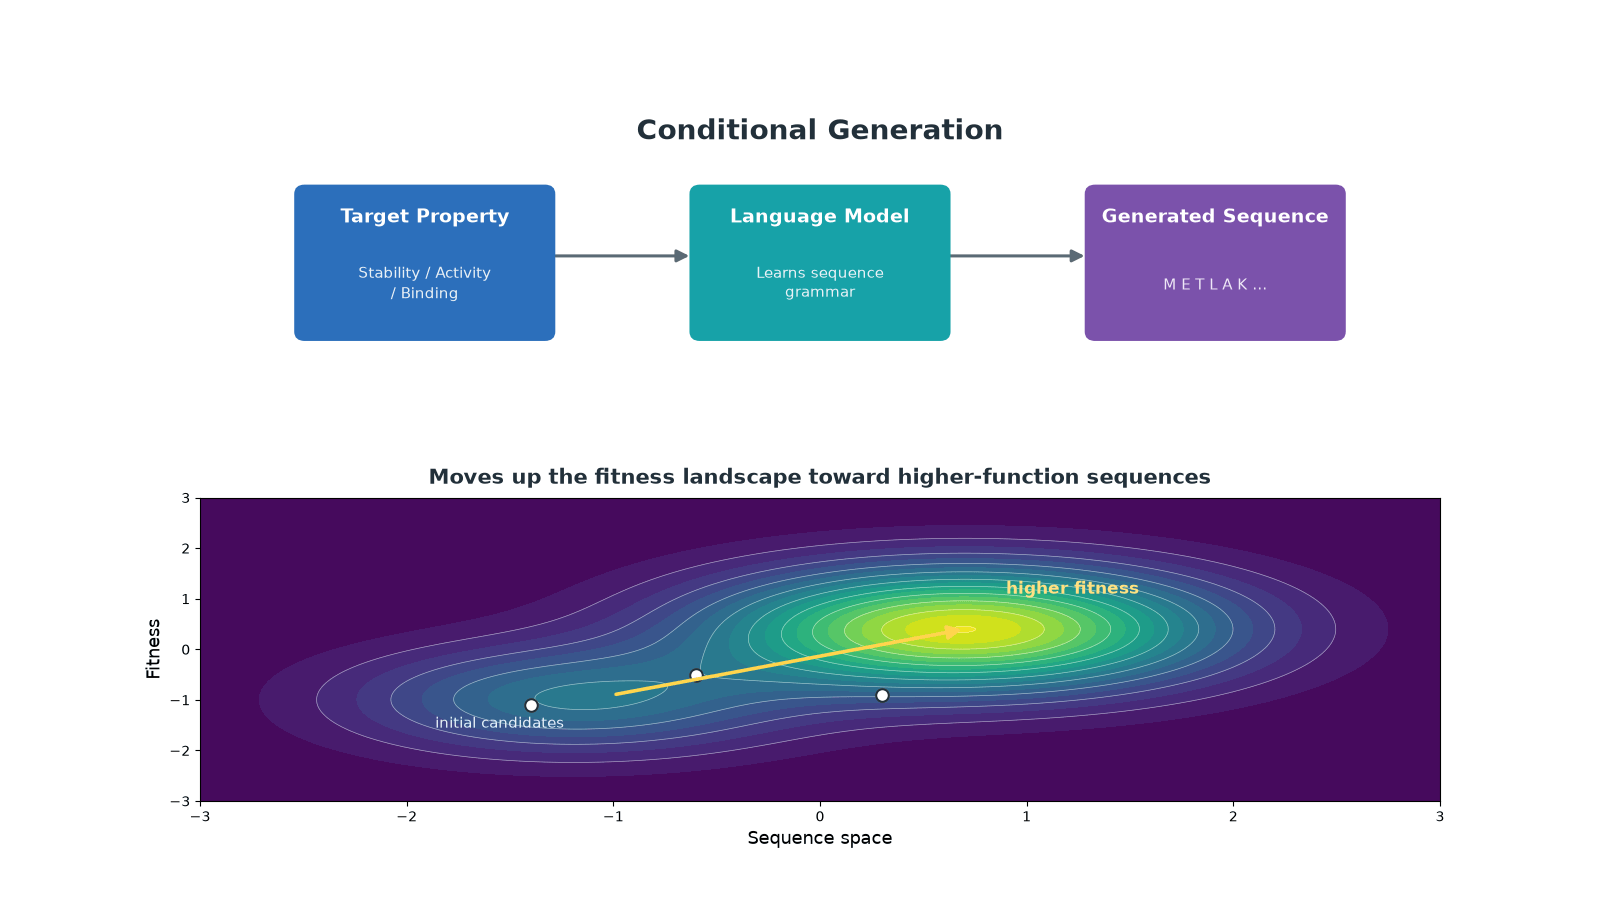 图2:按目标性质条件生成,并在适应度景观上移动
如何评估“生成”出来的序列是否靠谱?
生成的序列只是候选,必须依次通过计算打分、结构可行性与可开发性检查,以及湿实验验证,才能确认其真实功能。
先做计算筛选(in silico)。
第一步看结构:用结构预测模型观察它能否折叠成目标构象。
第二步看性质:用预测工具估算溶解度、稳定性、是否易聚集。
第三步看“可开发性”:与天然序列的相似度、免疫原性风险、整体相容性。
计算筛选能快速淘汰大量不靠谱的候选,但真正的“裁判”还是湿实验——表达、纯化、功能测定:把候选序列合成成基因,在细胞里表达,测它到底有没有预期的活性、稳定性或结合力。
只有通过实验的序列,才算真正“可用”。
随之而来的是闭环:把实验数据反馈给模型,让下一轮生成更聚焦、更高质量。
这种“生成—筛选—实验—再生成”的迭代,正是主动学习(active learning)的核心,也让每一轮实验都更有价值。
从“生成”到“下线”:工艺流程与条件如何设定?
一次完整的蛋白质序列生成落地,通常经历“目标定义→模型生成→计算筛选→湿实验验证→数据回流”五个环节,具体条件需随目标蛋白与用途调整。
1. 定义目标:更高的活性?更强的耐热?更高的产量?更精准的结合力?目标越清晰,条件生成越有方向。
2. 模型生成:让模型产出成百上千条候选序列。
3. 计算筛选:用结构与性质预测快速过滤,只保留少数高质量候选。
4. 湿实验条件:这是最需要针对具体蛋白优化的部分。
表达宿主(大肠杆菌、酵母、哺乳细胞等)、培养基、诱导温度与时间、纯化缓冲体系、活性测定方式,都要按目标与蛋白特性调整。
5. 数据回流:记录每轮结果、关键参数与失败信息,反馈给模型,让下一轮更高效。
循环往复,逐步逼近目标。
常见误区是“生成得越多越好”。
实际上,在计算端与实验端之间找到恰当比例——既不浪费算力,也不烧钱做无用实验——才是决定成本与成功率的关键。
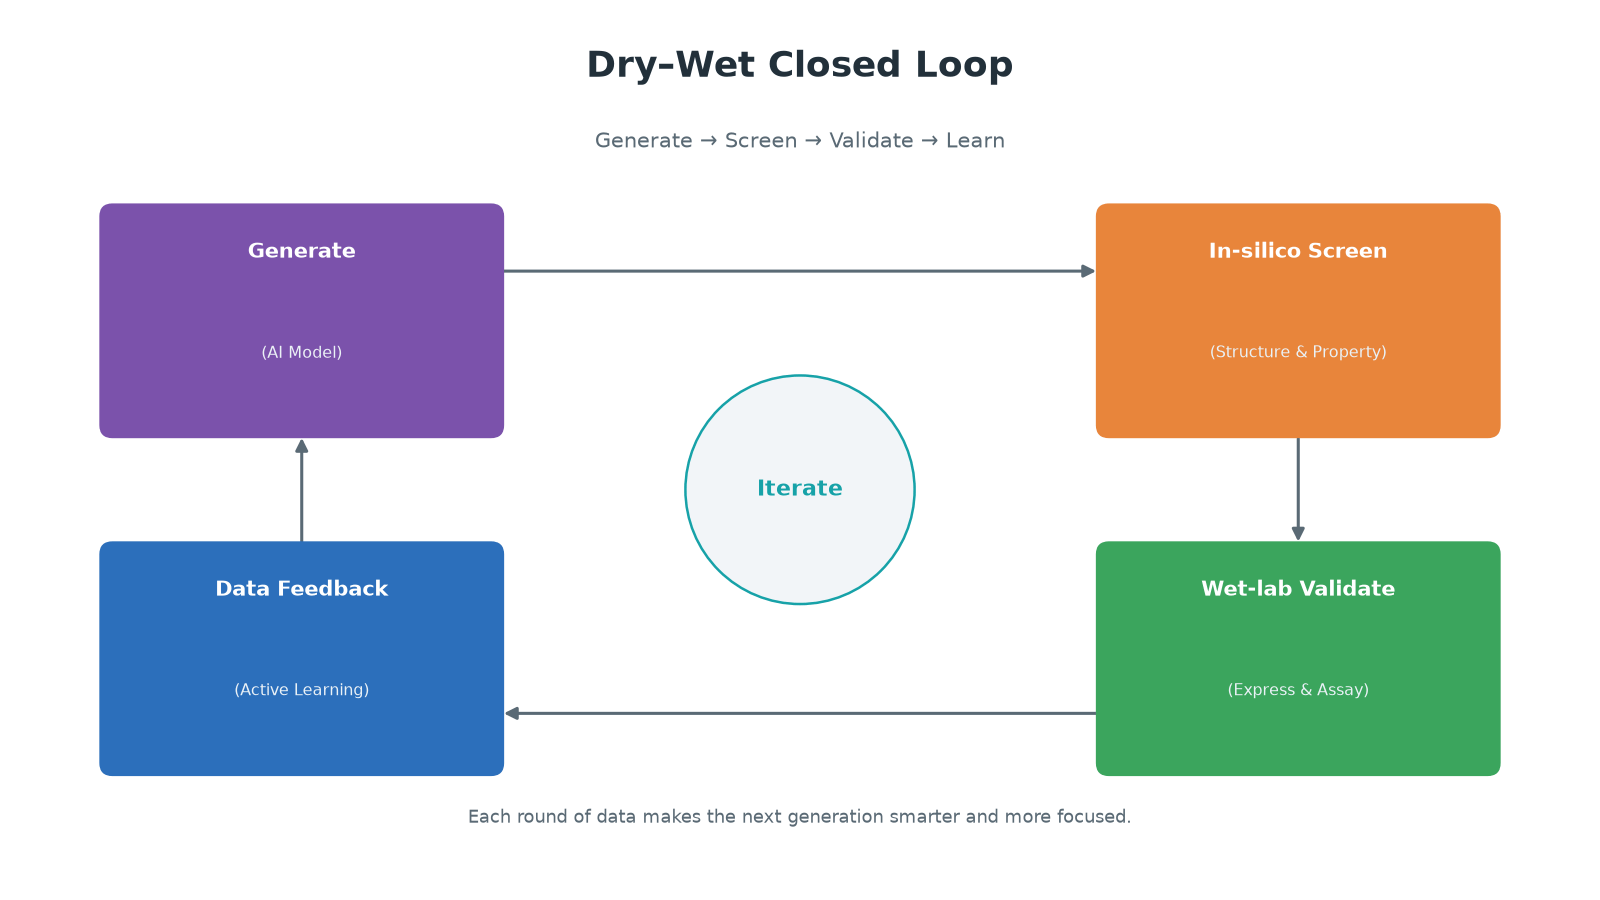 图3:生成—筛选—验证—学习,干湿闭环让数据更聚焦
MatwingsVenus®(晓鹜®) 如何把“序列生成”变成生产力?
MatwingsVenus®(晓鹜®) 把生成式设计与干湿闭环打通,用序列生成、功能预测与高通量筛选协同,让蛋白工程从“想法”到“落地”更快、也更可靠。
作为天鹜科技(Matwings Technology)旗下的人工智能蛋白质设计平台,MatwingsVenus®(晓鹜®)正把“蛋白质序列生成”从实验室课题变成可复用的生产力工具。
它把多个能力串成一条完整链路:从 VenusX 的功能位点映射,到 VenusREM 的单点扫描、VenusPrime 的多位点协同建模,再到 VenusFold 的结构预测、VenusG 的性质预测,配合 VenusMine 的结构挖掘,共同覆盖“设计—预测—筛选—验证”的每个环节。
更重要的是干湿闭环:AI 负责生成与预测,湿实验负责验证与反馈,主动学习让每一轮实验产出最大信息量,从而在更短周期内逼近目标序列。
这套思路可服务多种场景,例如酶催化效率提升、抗体亲和力成熟、蛋白热稳定化设计,以及从头设计新结合蛋白。
对商业而言,这意味着更短的开发周期、更低的试错成本、更高的成功率。
当然,具体性能数字应以真实项目数据为准,这里不做臆测。
FAQ
FAQ 1:蛋白质序列生成能直接“造”出可用的蛋白质吗?
不能一步到位。
生成模型给出的是候选,必须经计算筛选与湿实验验证,才能得到真正可用的蛋白质。
FAQ 2:蛋白质序列生成和定向进化有什么区别?
定向进化靠随机突变加大量筛选,序列生成靠模型定向设计。
二者常结合使用:生成提供方向,实验验证功能。
FAQ 3:生成式模型会不会“编造”不存在的蛋白质?
模型会生成天然不存在但合理的序列,这正是它的价值所在。
但必须用结构与功能验证确认可用性,避免“看起来合理却不可折叠”。
FAQ 4:没有蛋白质结构数据也能做序列生成吗?
可以。
蛋白质语言模型仅凭大量序列即可学到规律;若再有结构或功能标签,便可做更定向的条件生成。
总结
蛋白质序列生成把蛋白工程从“碰运气”变成“有方向的设计”,关键在于模型、数据与湿实验验证三者闭环协作。
回顾全文:原理上,它借蛋白质语言模型或扩散模型学习序列规律并条件化采样;评估上,必须经过计算筛选与湿实验验证;工艺上,遵循“目标—生成—筛选—验证—回流”五环节;平台上,MatwingsVenus®(晓鹜®)正是靠干湿闭环把这些环节串成生产力。
随着数据与算力提升,序列生成会更快、更智能,但实验永远是最终把关者。
研究:太阳系或再添一颗矮行星>>点击查看更多
10月29日午间题材主力资金:大飞机概念净流入11.58亿元居首,空间站概念、时空大数据、卫星互联网紧随其后>>点击查看更多
地矿光谱仪选型:野外便携和在线检测怎么取舍>>点击查看更多
人多抢网真烧心!从技术原理到实测数据,看天际通拥塞加速值不值>>点击查看更多
热门推荐