武汉东西湖人私藏,5万多株乔木环绕,这座天然氧吧美成油画
极目新闻记者 孙婷婷
秋日登高正当时。
10月11日上午,位于武汉市东西湖区的吴家山公园门口,一群练习广场舞的阿姨跟着音乐起舞,不远处练习唱歌的市民亮开嗓子。
歌声、舞步声和日光交织,唤醒了公园的早晨。
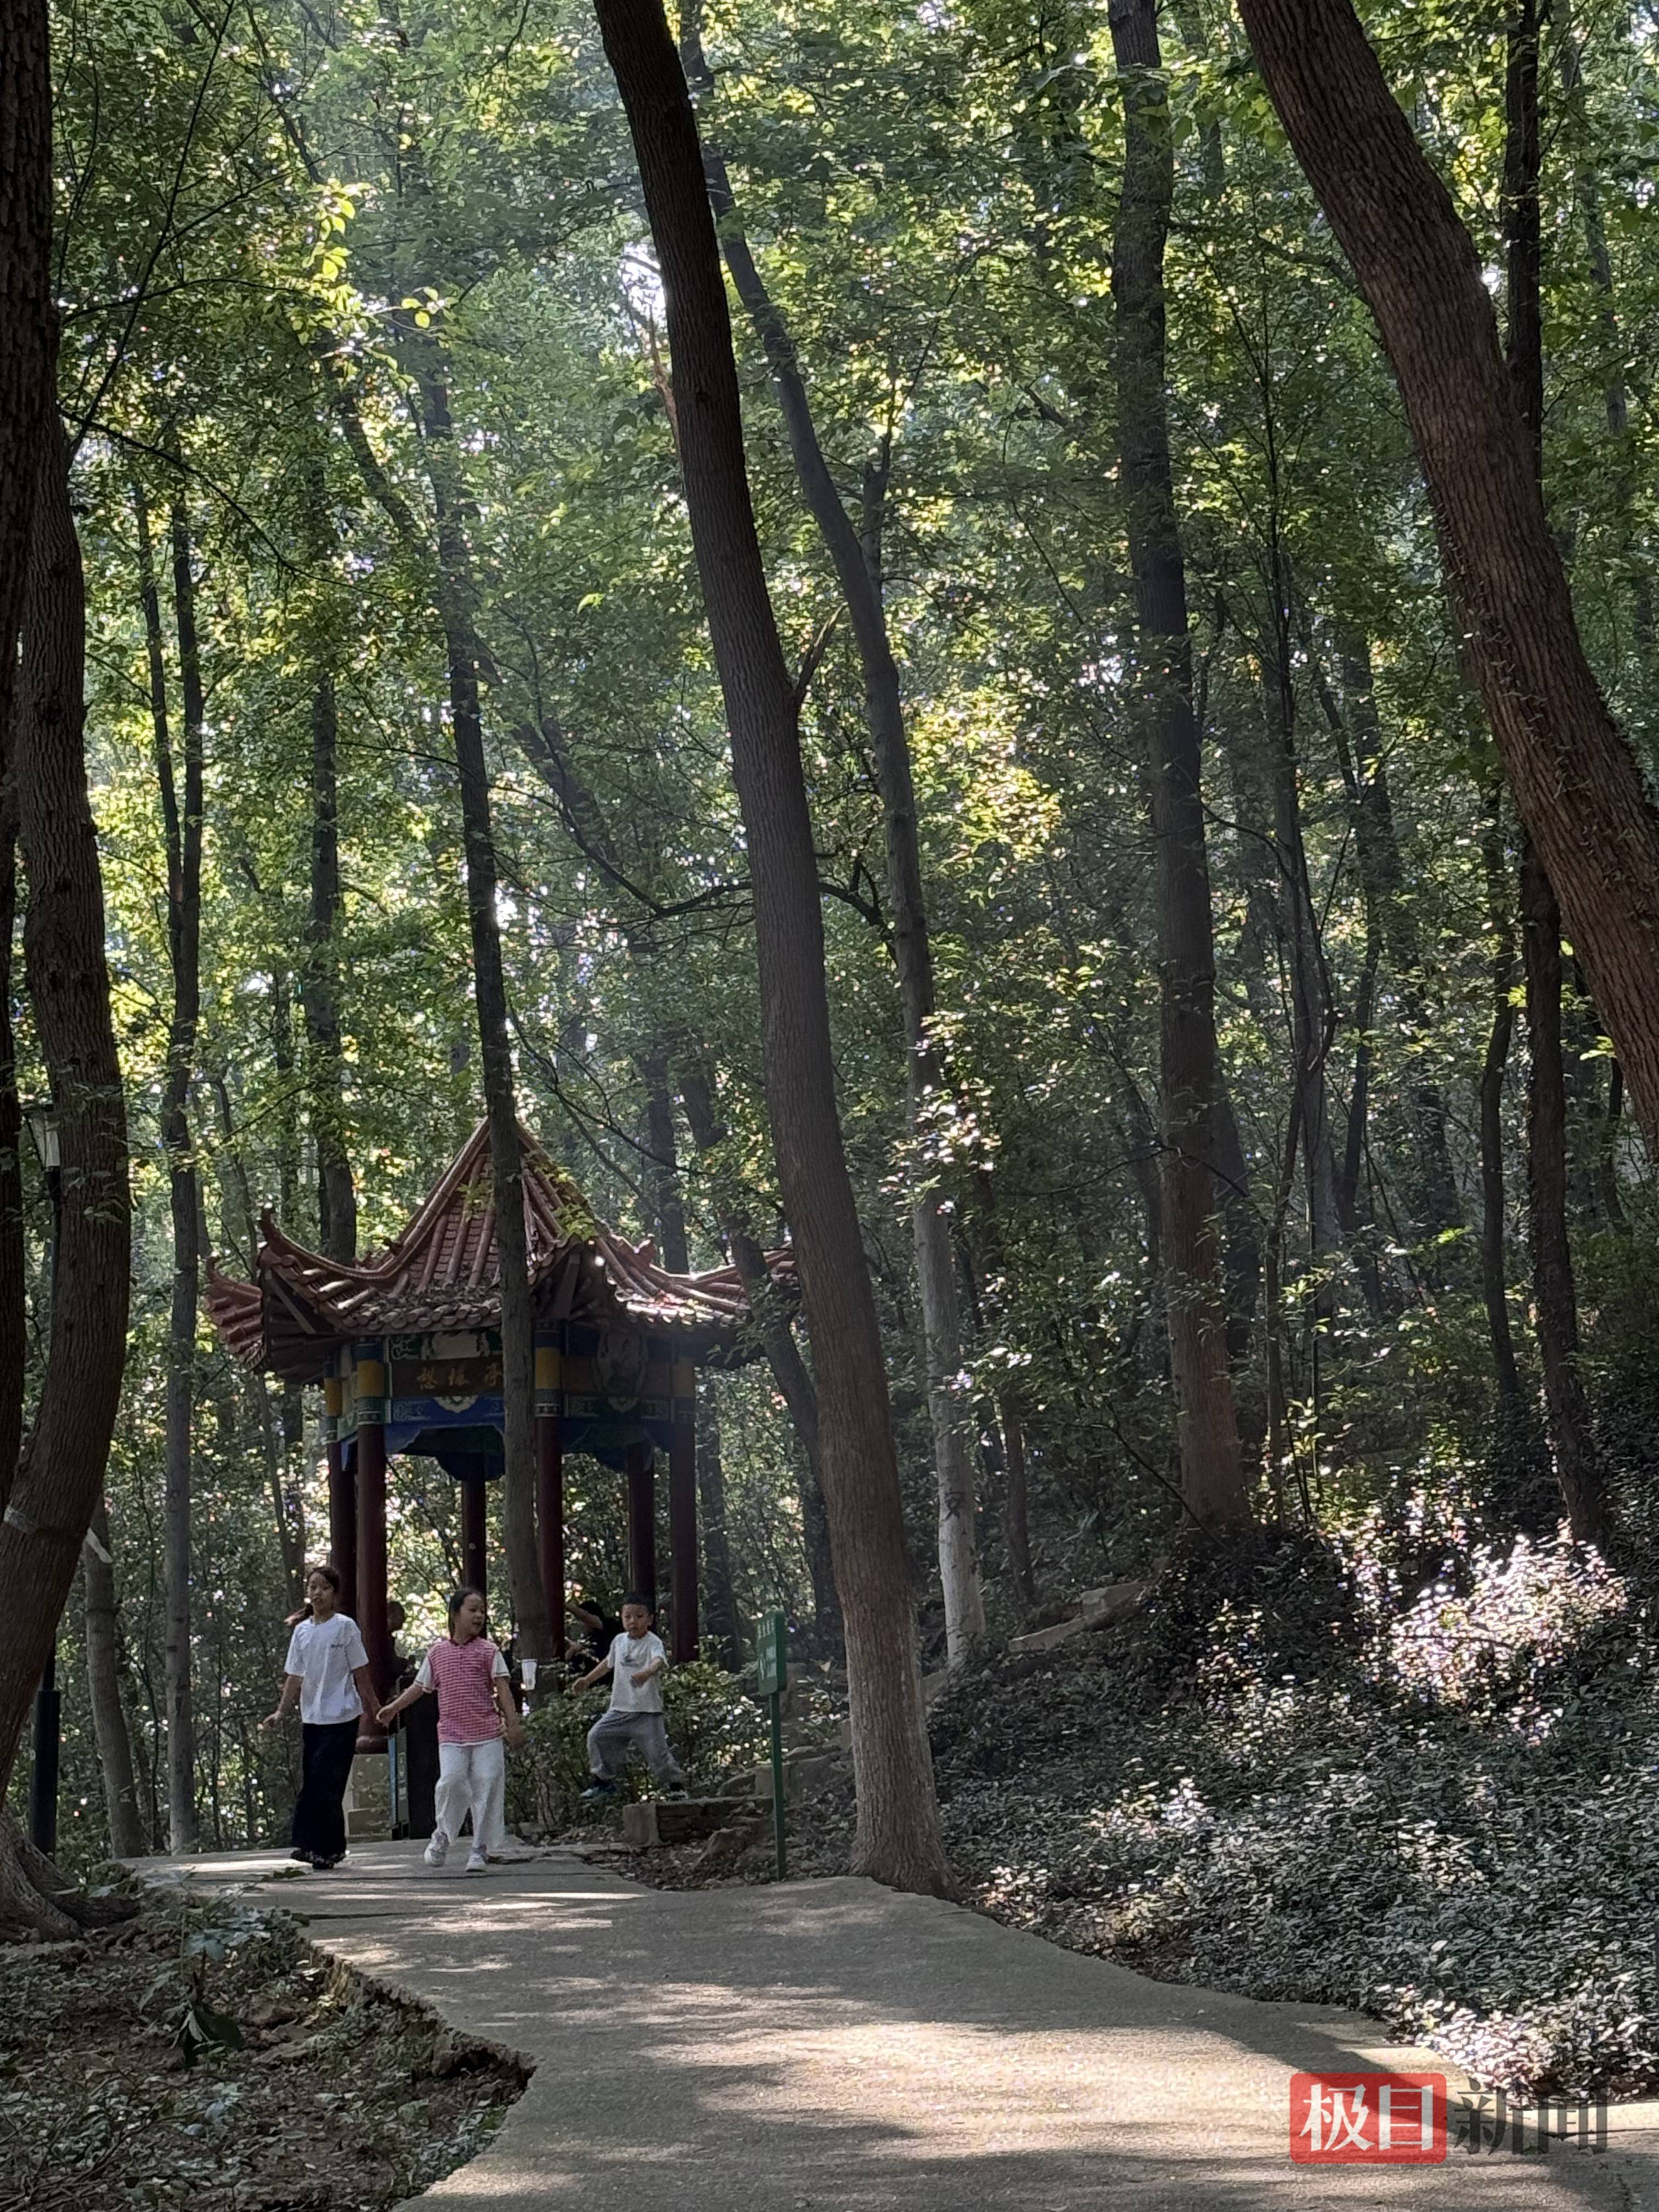
公园景色

公园现场
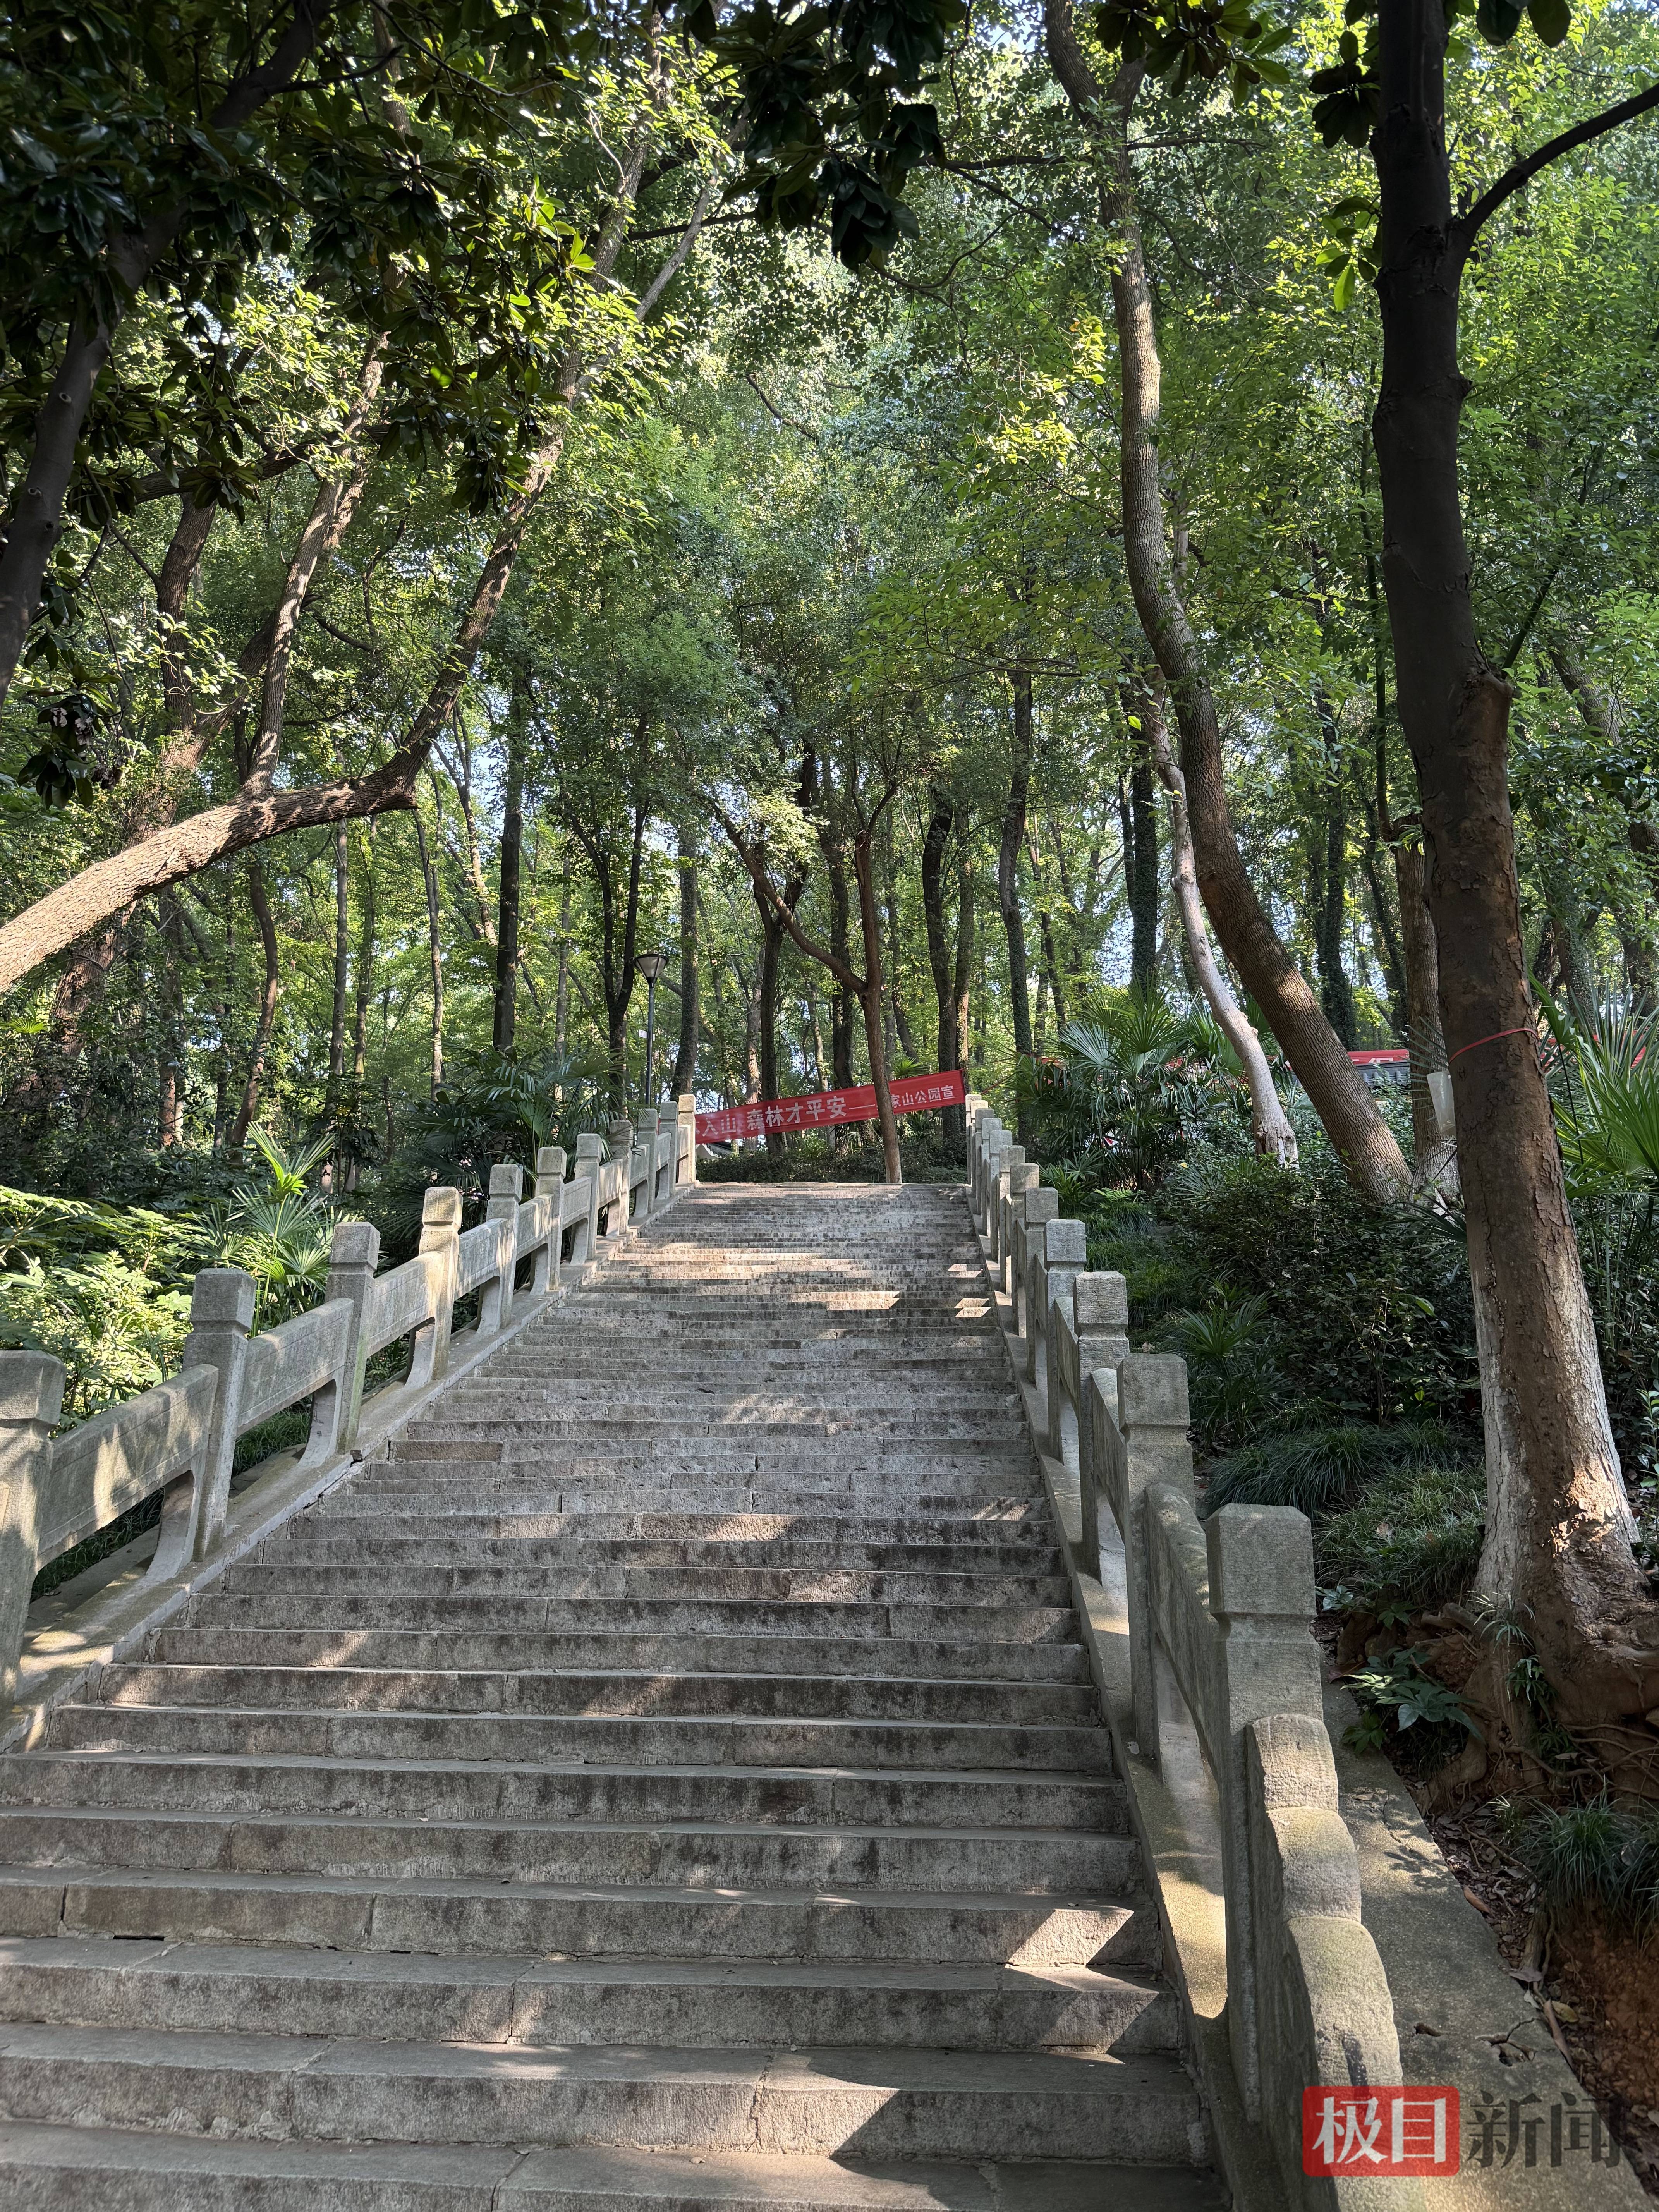
公园景色

公园景色
沿着环山道路前行,两侧香樟树高大挺拔。
阳光透过枝叶洒下,地面呈现斑驳光影。
山顶步道上,市民三三两两悠闲行走。
跑步的人群不时经过。
耳畔鸟儿鸣唱,城市喧嚣仿佛被绿荫隔开,只余下清新与宁静。
一位带着孩子一早来爬山的女士告诉记者,公园顶上很美,她经常带孩子来呼吸新鲜空气。
吴家山公园位于东西湖区机关驻地吴家山街中心,前身为山林,始建于1988年。
公园占地2700亩,海拔72.04米,为东西湖区境内海拔最高点,与五环广场一道构成东西湖区的文化休憩中心。
园内树木成荫,花繁叶茂,空气清爽,景色宜人。
据介绍,山上30年以上乔木有5万多株,每天能产生50亿立方米负氧离子,是吴家山中心城区的一座天然氧吧。
这也是一座红色教育公园。
山顶保留着一座抗日战争时期遗存的碉堡,提醒人们不要忘记战火纷飞的年代。
上世纪九十年代,东西湖区政府投巨资拆除周边大量建筑物,显山透绿,让吴家山公园旧貌换新颜。
如今,蓝天白云、绿树红花掩映着亭台楼阁,曲径通幽。
站在山顶放眼四望,临空港新城的雄姿和美景尽收眼底。
“春城婚育新风 幸福相伴同行”生殖健康科普在昆开讲
2026年10月23日,由昆明市计划生育协会、昆明市民政局指导,云南医景健康服务有限公司承办,昆明格蕾德明珠医院、松鼠口腔协办的“春城婚育新风·幸福相伴同行”2026生殖健康科普巡讲企业专场活动,在昆明云纺举行。本次活动聚焦职场职工婚育痛点,邀请昆明市延安医院妇科主任医师、昆明医科大学硕士生导师邓琦主任现场授课。
近200名年轻职工现场旁听了巡讲。
据介绍,巡讲围绕婚育规划、生育力保护、科学备孕、全周期孕育四大核心板块展开,同时覆盖婚育心理疏导、孕期及产后健康管理内容。
授课专家用通俗易懂的语言,讲解适龄婚育规划、男女双方生育力保护方法、备孕检查要点、孕期全周期照护、产后康复等实用知识,同时解答大家关心的生殖健康误区、内分泌调理、心理情绪疏导等热点问题。
“平时工作节奏快,很少有专门的时间系统去了解婚育、备孕相关知识,今天能面对面听专家讲课,机会很难得。
“一位企业职工表示,专家讲课解开了心中不少困惑,感觉这样走进企业的科普活动非常有必要。
昆明市计划生育协会相关负责人表示,持续开展婚育健康科普进企业,是打造生育友好环境的重要举措,把优质生殖健康服务送到职场一线,帮助职工科学规划婚育,减少孕育焦虑。
云南医景健康服务有限公司、昆明格蕾德明珠医院、松鼠口腔也表示,将充分发挥各自资源优势,做好此次的巡讲活动。
昆明格蕾德明珠医院聚焦生殖孕产保健、松鼠口腔提供的备孕及全周期口腔健康,也在现场为本次巡讲提供了医疗科普支撑与服务保障。
来源:都市时报 全媒体记者:茹伟 编辑:马东 审核:孟俊 二审:陈唯一 终审:彭德光
AI又长本事了!只需一句话,就能生成蛋白质
记者10月22日从西湖大学获悉,该校科研团队与香港科技大学(广州)、中国科学院深圳先进技术研究院团队合作,搭建了名为Pinal的人工智能(AI)模型。只需给该模型提供一句文字描述,它就能生成与已知天然蛋白序列不同、并可能具备实际功能的候选蛋白质。
相关研究成果日前在线发表于《自然》杂志。
蛋白质是生物大分子,其借助层层折叠出的精确空间结构,发挥各种特定功能。
“在冷冻电镜重构出的三维结构中,蛋白质呈现复杂而精密的折叠形态,成千上万个原子在纳米尺度内有序排布。
”西湖大学工学院特聘研究员原发杰介绍,蛋白质设计的难点正在于其结构高度精密,局部变化可能影响整体折叠和功能。
近年来,随着技术的快速发展,AI已能够预测蛋白质结构与序列之间的关系。
西湖大学科研团队希望更进一步,直接用自然语言描述蛋白质的功能,让AI生成对应的蛋白质序列。
Pinal概念图。
(图片由 GPT-Image-2生成)西湖大学供图 在研究过程中,科研团队发现,这一尝试需跨越巨大的数据鸿沟:已知蛋白序列数据规模庞大,但经实验验证功能的数据相对稀缺,AI模型难以建立功能文字和蛋白序列之间的可靠对应关系。
为破解难题,科研团队提出以蛋白质三维结构作为中间桥梁的技术路线,以此来开发和训练Pinal模型。
他们整合了多种来源的蛋白质数据,构建了覆盖约1.35亿条不同蛋白质序列的训练数据集。
通过为同一蛋白质配备多种语言表述,团队最终构建了包含约17亿条“蛋白质-文本”配对的AI合成训练数据集,为Pinal模型学习语言描述与蛋白质之间的关联提供了基础。
该模型运行大致分为三步:先根据文字生成蛋白质的结构蓝图,再依据结构排布氨基酸,最后对众多候选氨基酸序列打分,挑出最符合目标的候选序列。
科研团队选取荧光蛋白、降解PET塑料的酶、醇脱氢酶以及穿梭H蛋白四类功能迥异的蛋白质开展实验验证。
四类实验共同证实,Pinal模型可以设计出区别于已知天然蛋白序列且在实验中发挥目标功能的蛋白质。
原发杰表示,目前基于自然语言描述的蛋白质设计模型仍处于概念验证阶段,更多精细化的蛋白质功能设计需求,例如通过语言指令指定荧光蛋白的发光波段,是团队以及科技界当下面临的科研挑战。
来源:科技日报